简介
Lu.Xing
记录日常所思所想。
文章
全部 4 篇- 2026.08.30vLLM 与 SGLang 的前缀复用:Block Hash Chain vs Radix Tree两者都支持共享前缀复用,但底层数据结构不同。从源码出发对比 vLLM 的 Block Hash Chain 与 SGLang 的 Radix Tree,说明各自如何表示前缀、如何在分叉处停止命中,以及匹配粒度差异。
- 2026.08.20AWQ 如何通过基于缩放的方法降低量化误差从量化误差的传播路径出发,推导 AWQ 为什么用激活值寻找显著权重、缩放为什么能降低误差,以及缩放系数为什么不能无限大。
- 2026.08.144GB 显存跑 vLLM:三道显存闸门与 12 组实测在 RTX 3050 Ti Laptop 4GB + WSL2 上用 vLLM 跑 Qwen2.5-VL-3B-AWQ,把启动期的显存失败拆成三道闸门,用 12 组扫描量出 non_kv、offload 上限与 batching 的真实收益。
- 2026.05.28Hello, World站点第一篇,简单说说为什么写博客,以及这里以后会写些什么。
项目
全部 5 个 CUHK-X 隐私保护视频多模态问答面向 CUHK-X 大模型赛道的端到端可复现方案:红外视频固定抽帧、视觉语言模型推理、按题型约束解码,以及 QLoRA 后训练。Qwen3.5-4B 经 QLoRA 微调后,Kaggle 分数由 baseline 的 0.444 提升至 0.547,较最初的 Qwen2.5-VL-7B baseline 累计提升 0.129。
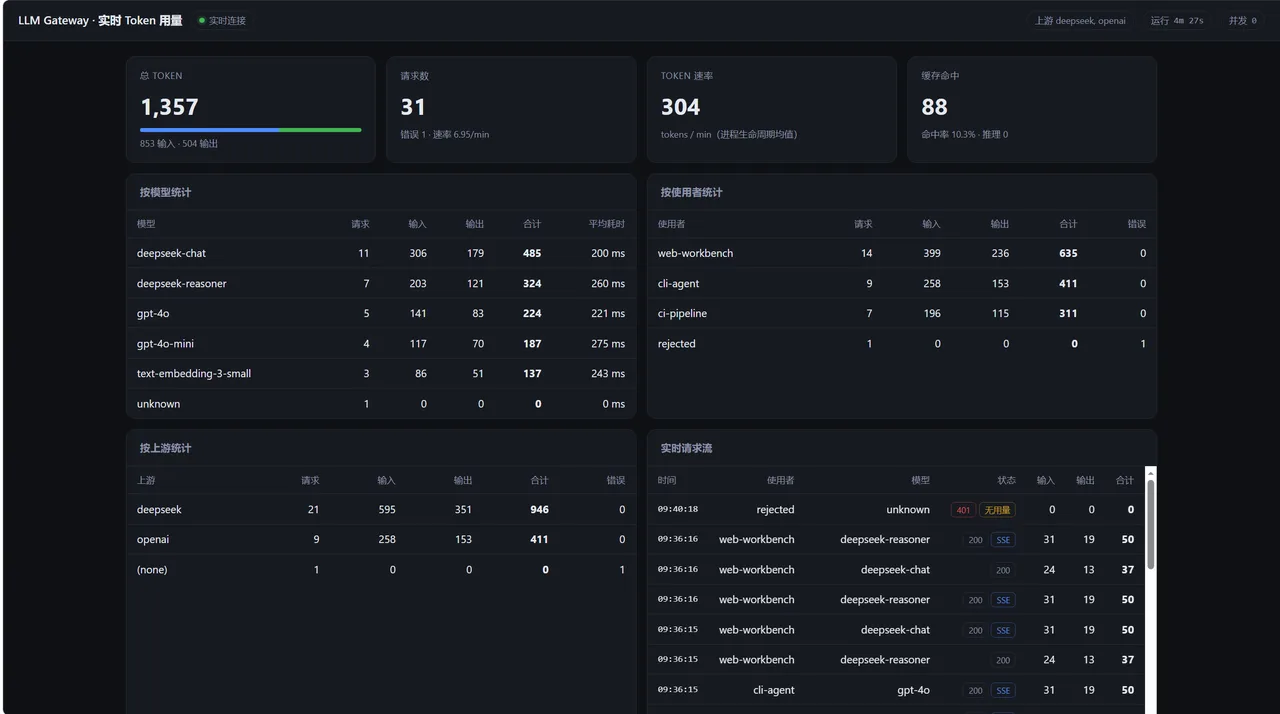 llm-gateway给 LLM 调用加一层计量表。轻量的 OpenAI 兼容反向代理,转发请求的同时实时统计 token 用量,按使用者、模型、上游三个维度拆分展示。密钥隔离在多上游之后,工作台只需网关下发的 key;流式转发不缓冲,另带实时面板与 Prometheus 指标。
 QuantAssay在真实 SGLang 服务路径上对比 BF16 与 GPTQ/AWQ W4A16,测量推理延迟、吞吐与困惑度,并生成可复现报告。
 KernScope面向资源受限 GPU 的 LLM 推理算子库,提供 RMSNorm 与融合 Add-RMSNorm 的 PyTorch 参考实现和 Triton CUDA 内核。